Как компьютер учится видеть кошку
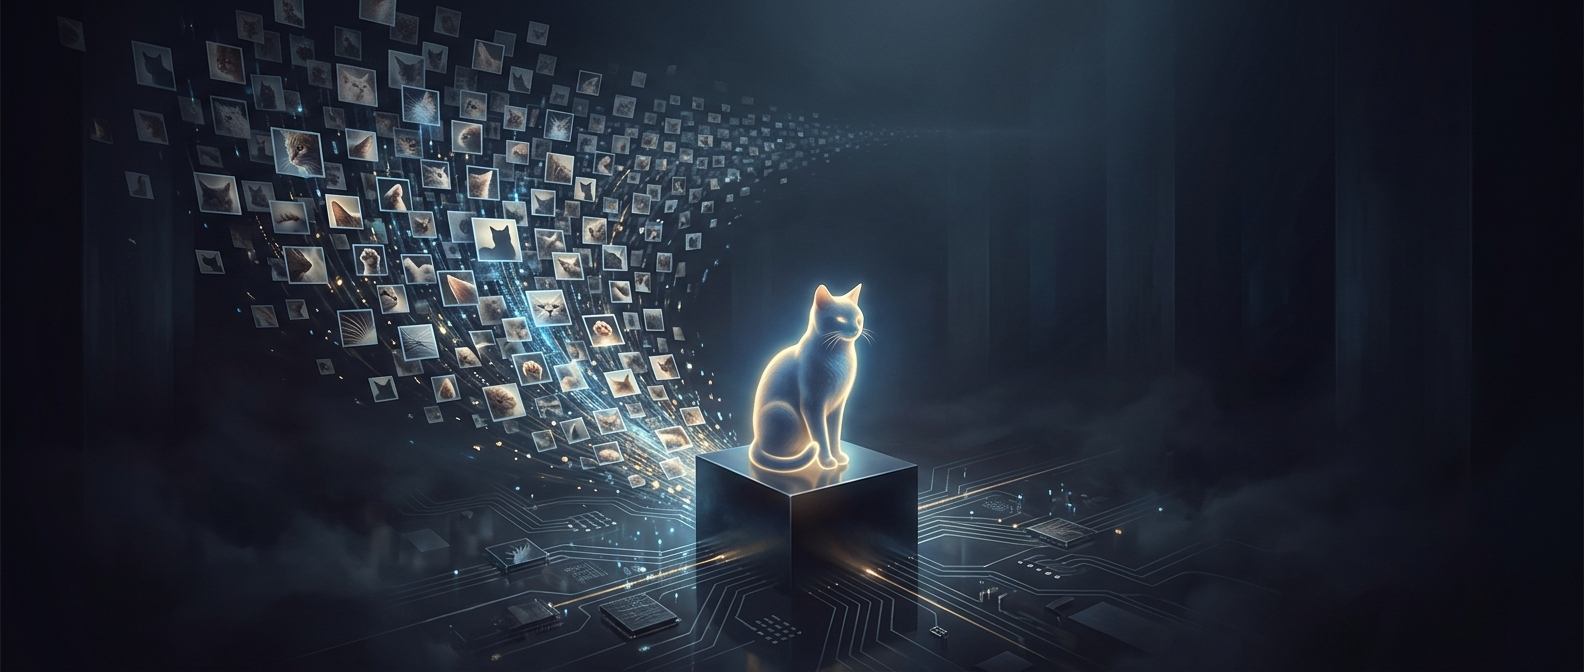
Для человека кошка — не просто набор цветов и линий: мы узнаём знакомую форму, даже если животное свернулось клубком или частично закрыто. Компьютеру приходится учиться этому различию на примерах. Ему показывают изображение и сообщают, что на нём изображено: это называется разметкой.
На обучении алгоритм сопоставляет метки с узорами в пикселях — например, контурами ушей, расположением глаз и характерными переходами цвета. Сначала он часто ошибается. Затем система меняет внутренние настройки так, чтобы в следующий раз правильный ответ был вероятнее. Миллионы размеченных изображений дают ей множество вариантов: кошки в разных позах, при разном освещении и на разных фонах.
Почему может сбить с толку тост
Если на кусочке хлеба случайно сложились тёмные пятна и округлые очертания, издалека он может напоминать морду. Алгоритм не «понимает» эту шутливую похожесть по-человечески: он оценивает, насколько увиденные узоры совпадают с теми, которые встречал на примерах. Чем разнообразнее обучающие изображения, тем выше шанс, что он отличит кошачью морду от случайного рисунка на корочке.
Важно не только количество картинок, но и их разнообразие и качество меток. Если почти все кошки на снимках белые, а тосты в наборе данных отсутствуют, система может хуже справляться с необычными случаями. Поэтому изображения подбирают так, чтобы алгоритм учился не запоминать один фон или цвет, а находить признаки, устойчивые в разных условиях.
Откуда берутся вычислительные затраты
Для обучения требуется многократно обработать большое число изображений и пересчитать множество настроек модели. Чем больше примеров и сложнее модель, тем больше вычислений может понадобиться. Результат — не безошибочное зрение, а навык распознавания, сформированный на опыте: иногда именно дополнительные примеры помогают системе не принять удачно подрумяненный тост за кошку.