Как изображение превращается в текст
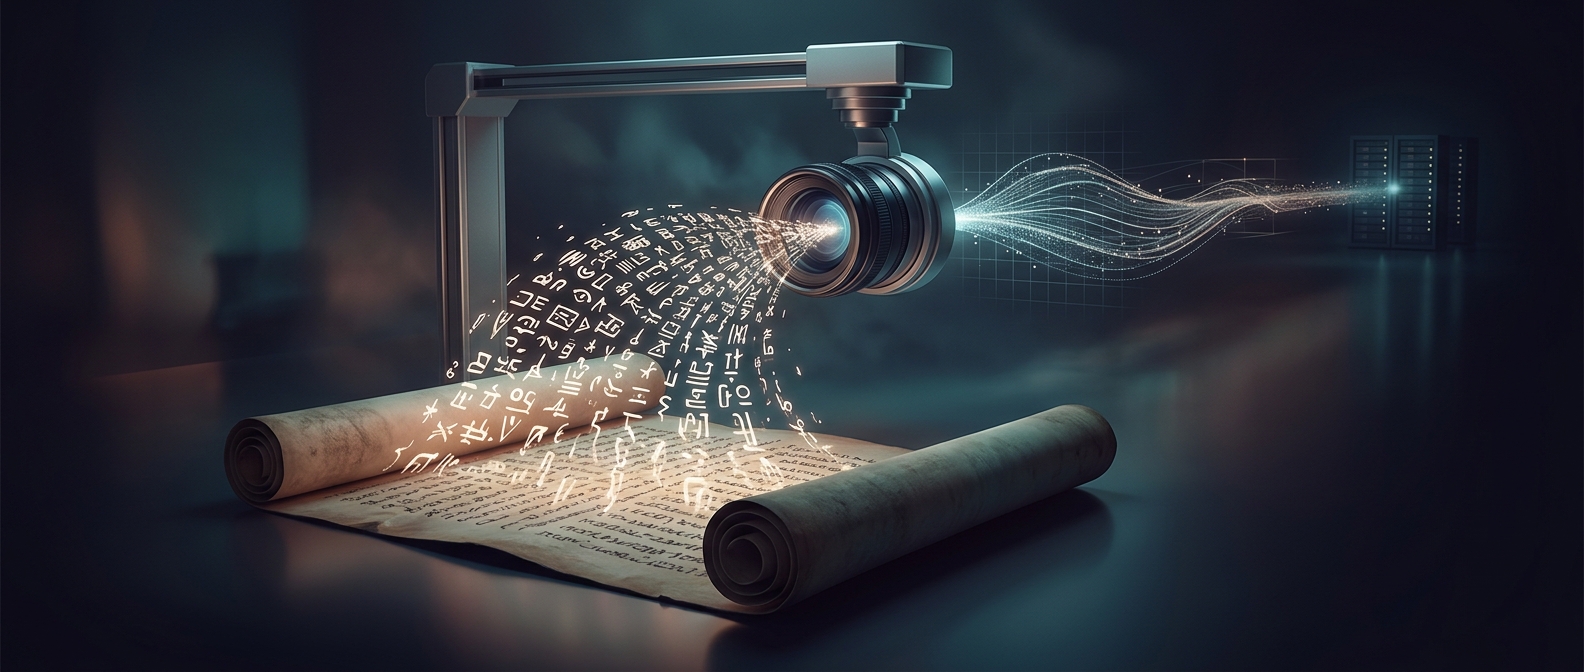
Скан для компьютера — не страница со словами, а сетка пикселей. OCR (оптическое распознавание символов) сначала выделяет области с текстом, затем оценивает, какие буквы и слова могли оставить эти тёмные пятна. Размытый край, низкое разрешение, пятно или необычный шрифт меняют очертания букв; в результате алгоритм может выбрать похожий вариант.
На практике распознавание не всегда идёт по одной букве за раз. Современные системы могут анализировать целые последовательности символов и учитывать, какие сочетания чаще встречаются в языке. Это помогает восстановить смазанный текст, но не даёт гарантии: незнакомое имя, редкое слово или плохой скан способны перевесить подсказку контекста. Поэтому ошибка вроде превращения barn в bum — не просто неверно нарисованная буква: система могла ошибочно оценить несколько символов вместе.
Почему одна ошибка портит поиск
После распознавания текст часто используют для поиска и копирования. Если слово стало другим, нужный фрагмент может не находиться по запросу, а автоматически извлечённая цитата — содержать опечатку. Само изображение страницы при этом остаётся прежним: ошибка возникает в текстовой версии, созданной программой.
Проверять особенно важно места, где цена подмены высока: имена, числа, цитаты и редкие термины. Если слово выглядит странно, полезно сверить его с изображением, а не полагаться только на распознанный текст. OCR делает скан доступным для поиска, но его результат — реконструкция изображения, а не безошибочная копия страницы.