Как модель выбирает продолжение текста
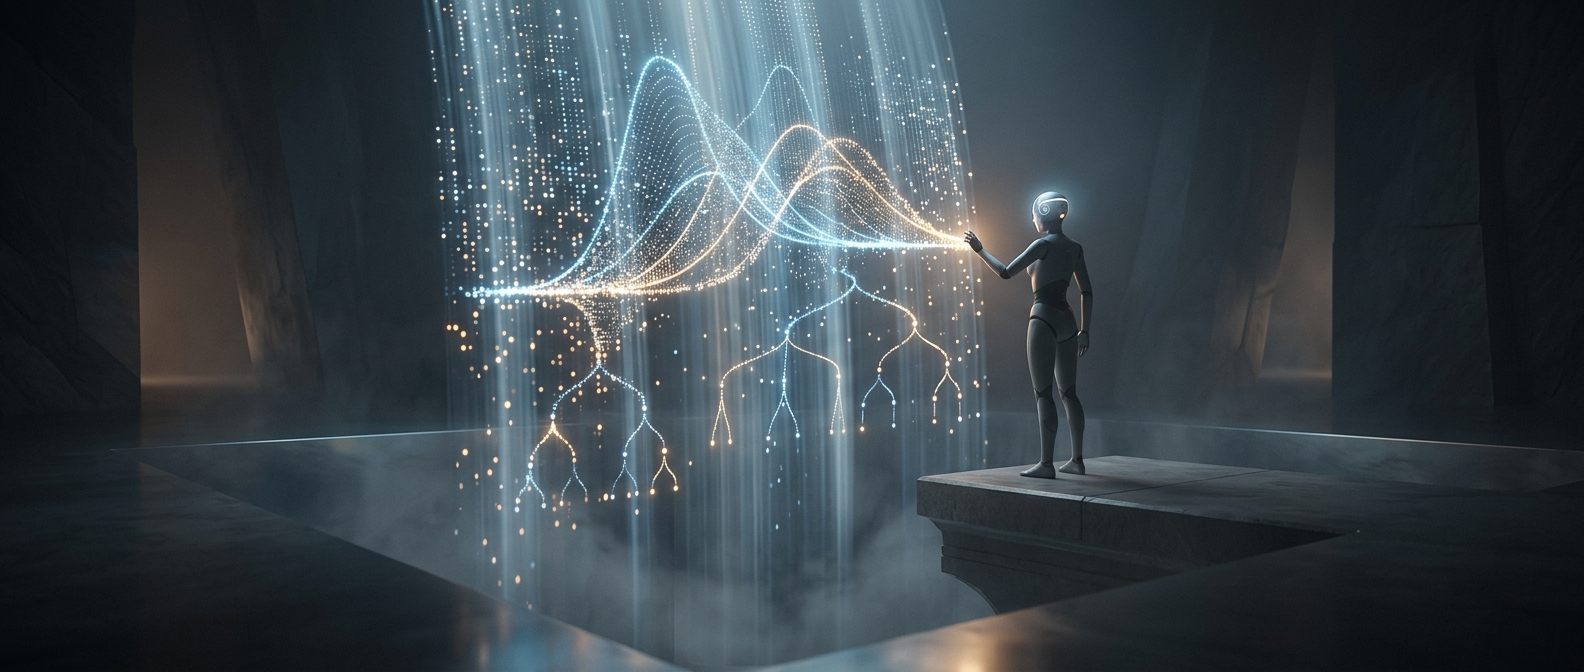
Сначала текст разбивают на токены — небольшие фрагменты: это может быть целое слово, часть слова, пробел вместе со словом или знак препинания. Поэтому модель не обязательно выбирает следующее слово целиком. Она получает уже написанные токены и оценивает, какие фрагменты могли бы идти дальше и насколько каждый из них вероятен в этом контексте.
Например, после «На небе появились тёмные…» продолжение «облака» обычно подходит лучше, чем случайный знак. Модель выбирает один из возможных токенов, добавляет его к тексту и выполняет ту же операцию снова — уже с обновлённым контекстом. Так ответ возникает по частям, а не извлекается целиком из готового хранилища.
Почему продолжение звучит связно — и может ошибаться
Во время обучения модель обрабатывает множество примеров текста и настраивает внутренние параметры так, чтобы лучше предсказывать пропущенное продолжение. Благодаря этому она усваивает закономерности языка: какие слова часто соседствуют, как строятся фразы и какой ответ обычно следует за вопросом. При генерации выбор может зависеть не только от самого вероятного варианта: система способна учитывать несколько подходящих продолжений, поэтому один и тот же запрос не всегда даёт дословно одинаковый ответ.
Однако вероятность языкового продолжения — не проверка факта. Фраза может быть грамматически уместной и убедительно звучать, даже если модель неверно назвала дату или смешала похожие сведения. Связность показывает, что продолжение подходит к контексту, но сама по себе не подтверждает его истинность. Именно поэтому гладкий ответ и достоверный ответ — не одно и то же.