Почему поисковик видит только доступную поверхность
Google не просматривает интернет так, как человек листает страницы. Его автоматические программы — поисковые роботы — переходят по ссылкам, находят новые адреса и сохраняют сведения о страницах в индексе, то есть в каталоге, по которому затем выполняется поиск. Чтобы попасть в этот каталог, страница обычно должна быть доступна роботу без особых разрешений и связана с другими страницами ссылками.
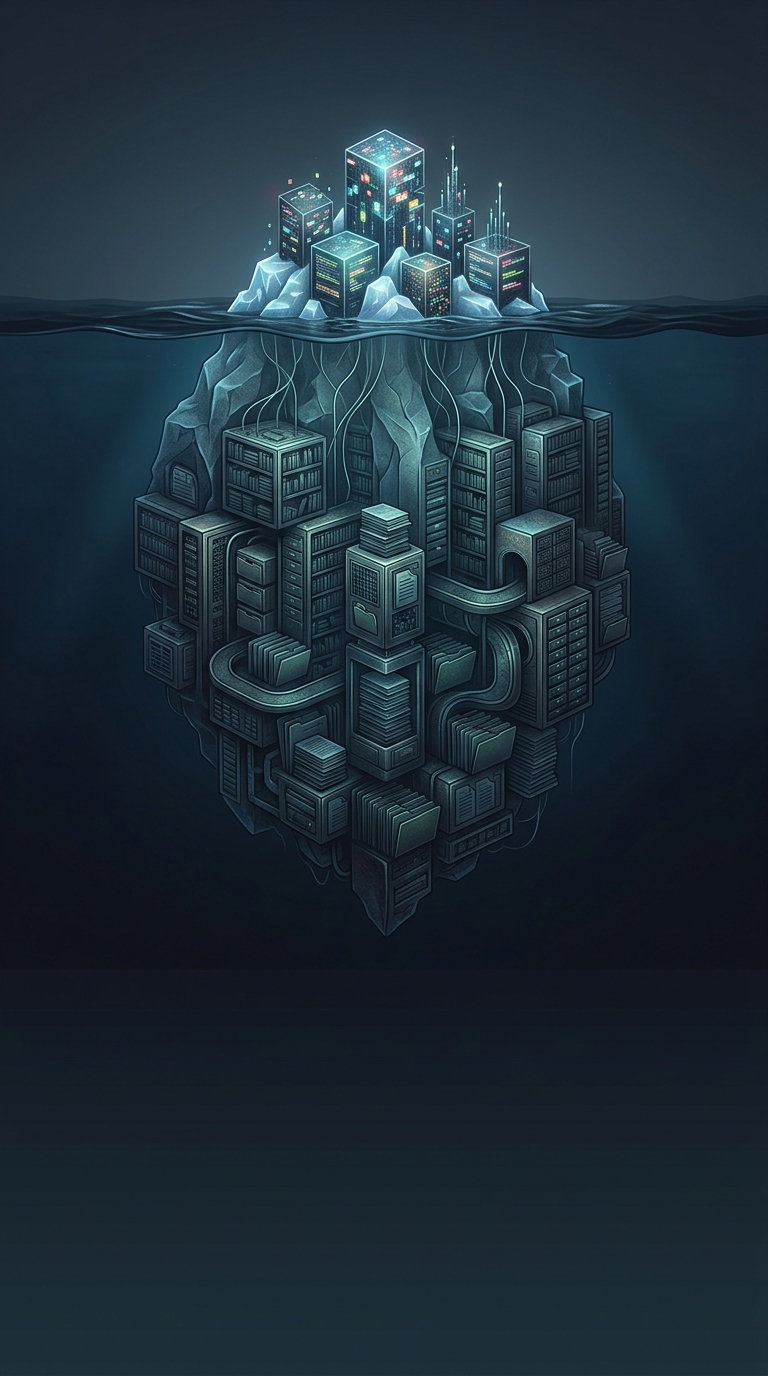
Поэтому оценку о пяти процентах стоит понимать как грубое сравнение видимой и скрытой частей сети, а не как точный замер неизменного объёма. Интернет непрерывно меняется, а его «невидимую» часть нельзя пересчитать единым способом: у неё нет общего списка страниц и даже одного очевидного знаменателя.
Что остаётся за пределами индекса
Большая часть скрытых данных не спрятана от закона — она просто предназначена не для публичного поиска. Академическая база может показывать записи только после входа в университетскую сеть или подписки. В корпоративном интранете — внутренней сети организации — документы доступны сотрудникам, но не внешним посетителям. Онлайн-банк, в свою очередь, формирует сведения о счетах отдельно для каждого клиента после авторизации.
Есть и страницы, которые возникают лишь в ответ на запрос: например, результаты поиска по каталогу или базе данных. Пока пользователь не заполнит форму, конкретного адреса с нужным содержимым может не существовать. Робот не может бесконечно перебирать все возможные запросы, а закрытый вход он не должен обходить. Владелец сайта также может технически ограничить автоматический сбор страниц.
Отсюда важное различие: «не индексируется» не значит «тайно» или «криминально». За пределами обычного поиска часто находятся рабочие документы, научные материалы и личные кабинеты. Поисковик показывает не весь интернет, а ту его часть, которую можно обнаружить, прочитать и безопасно включить в общий каталог.